
Article mis à jour le 30 septembre 2026 pour tenir compte des dernières évolutions du web agentique.
Ce modèle ne disparaît pas, mais il évolue. Une nouvelle couche s’ajoute au web : celle de systèmes capables de comprendre une intention formulée en langage naturel, de rechercher des informations, de comparer des options et parfois d’agir à la place de l’utilisateur. Le web n’est plus seulement un espace que l’on parcourt. Il devient progressivement un environnement que l’on peut interroger pour obtenir un résultat.
Ce basculement n’est plus seulement annoncé. On cherche de plus en plus via des interfaces comme ChatGPT, Gemini ou Perplexity. Adobe relève dans son rapport 2026 qu’environ un quart des consommateurs citent les plateformes IA comme leur première source de recherche, devant les sites de marques et les avis en ligne, même si les moteurs classiques restent dominants. En parallèle, la tendance du zero clic s’accélère : moteurs et assistants donnent de plus en plus souvent une réponse directement dans leur interface, sans toujours renvoyer vers un site. En 2026, le lancement d’AI Overviews et du Mode IA en France, l’apparition de parcours d’achat intégrés et la structuration progressive des protocoles agentiques montrent que l’étape suivante est déjà engagée : les assistants ne se contentent plus d’informer. Ils commencent à comparer, recommander, remplir une demande ou lancer une action.
Comprendre le web agentique, ce n’est donc pas suivre une mode de plus autour de l’IA. C’est essayer de voir comment les sites web vont être lus, utilisés et parfois contournés par de nouveaux intermédiaires logiciels. C’est aussi comprendre pourquoi, dans ce nouveau paysage, le CMS redevient une brique stratégique, non seulement pour publier, mais pour structurer, exposer, gouverner et protéger l’information.
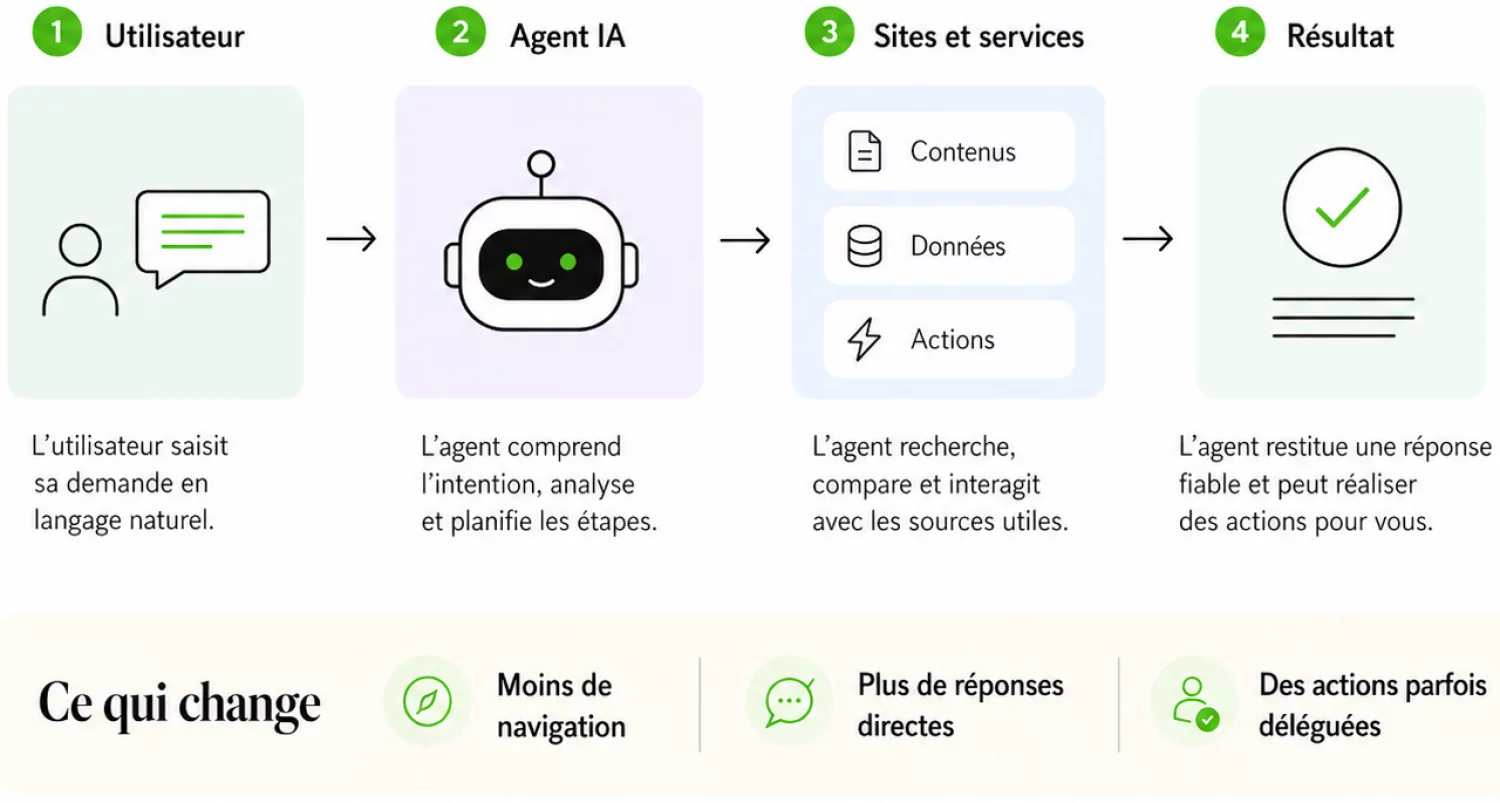
Un modèle de langage, le fameux LLM, produit du texte. Un chatbot répond à un échange. Une automatisation suit un scénario défini à l’avance. Un agent, lui, opère. Si on lui demande de trouver un outil adapté à une PME, de comparer des offres logistiques ou de réserver un créneau selon certaines contraintes, il peut aller chercher les informations, les organiser, arbitrer entre plusieurs options et agir sur cette base. C’est cette capacité à passer de la réponse à l’exécution qui change tout.
Sur un site de services, cela peut vouloir dire consulter des disponibilités, rapprocher plusieurs contraintes et préparer une prise de rendez-vous. Sur un site B2B, cela peut vouloir dire qualifier un besoin, retrouver la bonne ressource, structurer une demande ou préremplir un formulaire. Sur un site e-commerce, cela peut vouloir dire rechercher plusieurs produits, comparer leurs caractéristiques, vérifier leur disponibilité et proposer une sélection cohérente, voire aller jusqu’à l’ajout au panier ou à la préparation d’une transaction.
On le voit déjà dans des cas concrets. En janvier 2026, Carrefour a annoncé son adoption de l’Universal Commerce Protocol (UCP), le standard ouvert pour le commerce agentique lancé par Google au salon NRF, avec l’objectif de proposer des parcours d’achat intégrés directement dans Google Search et l’application Gemini dès que ces fonctionnalités seront déployées localement.
Puis en mars 2026, Carrefour a franchi une étape supplémentaire en lançant une intégration complète dans ChatGPT, devenant ainsi le premier retailer alimentaire européen à permettre de faire ses courses directement depuis l’interface d’OpenAI. Dans ces deux cas, on voit bien le glissement en cours : on passe d’interfaces qui informent à des systèmes qui commencent à guider, orchestrer et préparer une action réelle.
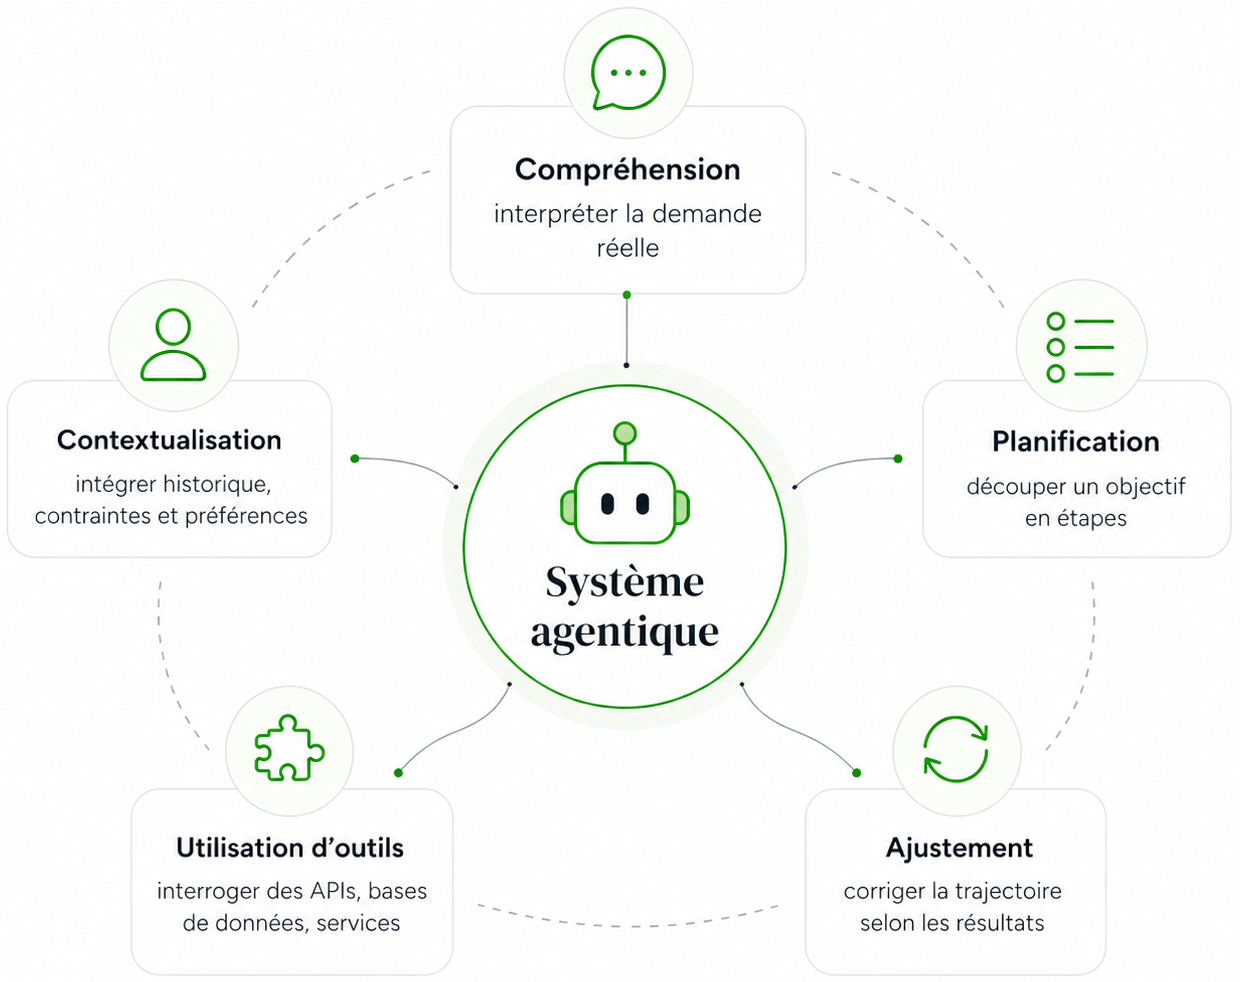
Ce point est important pour les professionnels du web. Un site pensé pour une IA générative doit être lisible. Un site pensé pour des agents doit être à la fois lisible, interrogeable et, parfois, actionnable.
Fin septembre 2026, OpenAI a présenté Dots, des agents conçus pour poursuivre un travail entre plusieurs conversations et revenir vers l’utilisateur avec des résultats à valider. Cette logique d’agent persistant marque une étape supplémentaire : l’utilisateur ne déclenche plus seulement une action ponctuelle, il délègue un objectif dans la durée. Elle rend d’autant plus importante la définition préalable de ses limites d’action.
Cet encadrement ne repose pas uniquement sur une validation humaine. Il suppose aussi des permissions limitées, des confirmations avant les actions sensibles, une journalisation des opérations, des accès révocables et une responsabilité clairement définie en cas d’erreur. En pratique, beaucoup d’usages réels se situent encore entre recommandation, orchestration et exécution partielle. Pour les entreprises, le bon réflexe n’est donc pas de tout reconstruire dans l’urgence, mais de préparer progressivement le terrain.
Le véritable changement est venu avec les grands modèles de langage, capables de mieux comprendre les demandes humaines, leur contexte et leur complexité. Tant qu’ils restaient cantonnés à la production de réponses, on demeurait dans une logique conversationnelle. Le basculement vers l’agentique s’est produit lorsqu’ils ont commencé à utiliser des outils externes, comme des APIs, des services web ou des systèmes métiers, pour agir au-delà du simple texte.
Si l’accélération est si forte depuis peu, c’est parce que plusieurs conditions sont désormais réunies : des modèles plus robustes, des usages conversationnels déjà installés, des investissements massifs des grandes plateformes et l’émergence progressive de standards d’interconnexion. Le web agentique n’est donc pas un surgissement isolé. C’est le point de rencontre entre une maturation technique, une évolution des usages et un besoin croissant de simplifier des parcours numériques devenus trop complexes. Cette dynamique ne se limite pas aux grandes plateformes, elle touche aussi l’open source avec des projets comme Hermes Agent de Nous Research.
Pour situer ce changement, on peut résumer l’évolution du web assez simplement :
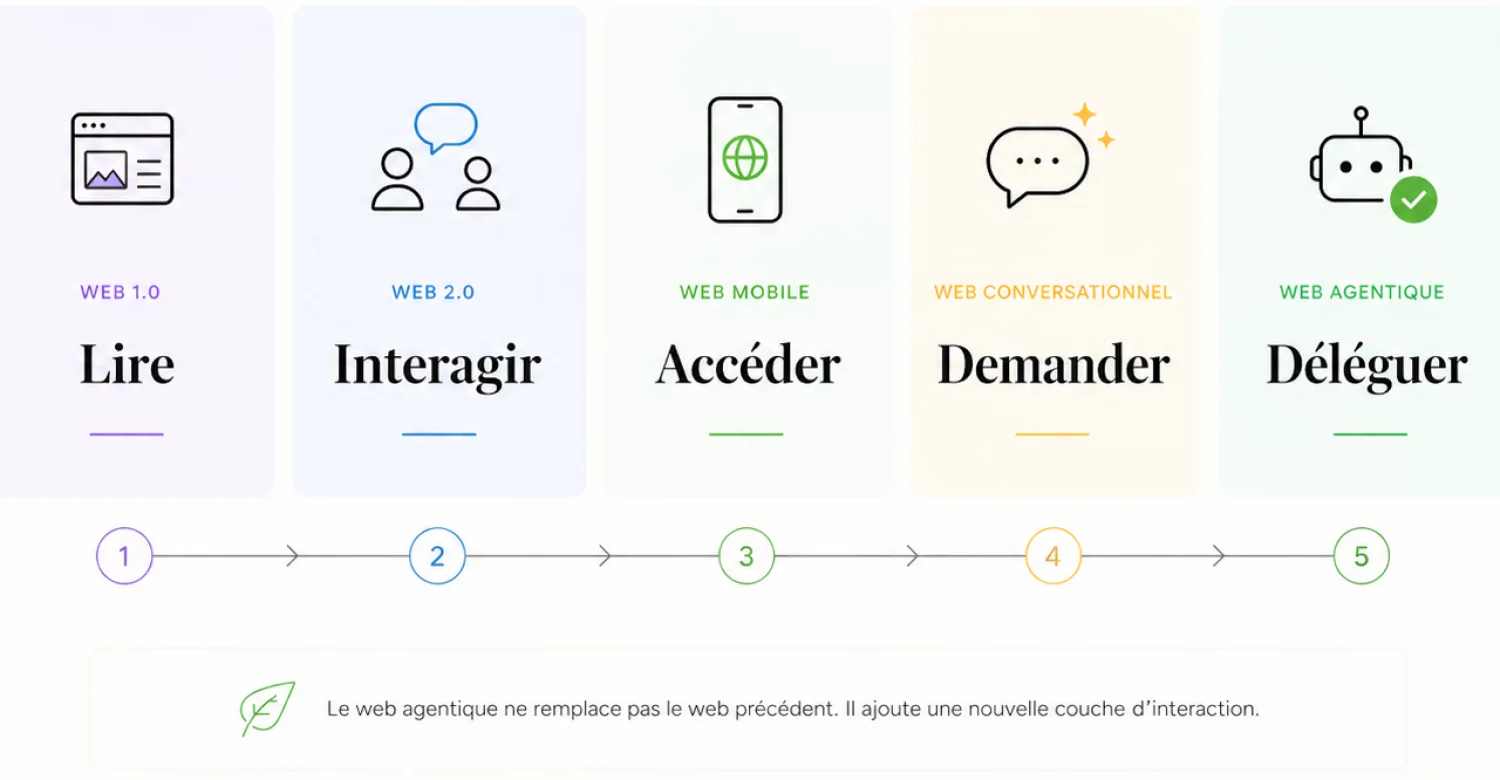
Cette progression illustre comment chaque phase a prolongé et reconfiguré les précédentes sans les effacer. Le web agentique ne fait pas exception : la navigation humaine reste présente, mais elle coexiste avec de nouveaux modes d’accès où l’intention est déléguée à un système intermédiaire.
C’est précisément là que la logique s’inverse : pour exister dans le web agentique, un site doit d’abord être compris et sélectionné par une machine avant d’atteindre l’utilisateur humain. Un site dont les contenus sont flous, les données peu structurées ou les services uniquement accessibles par une navigation humaine risque donc d’être ignoré, quelle que soit la qualité de sa présentation.
C’est ce que résume le modèle B2A2C (Business to Agent to Consumer) : l’entreprise ne s’adresse plus directement au consommateur, mais à l’agent qui le représente. Cela change la visibilité, la découverte et parfois la relation client elle-même.
Sur un site de services, les usages sont assez faciles à imaginer : prise de rendez-vous, qualification d’une demande, demande de devis, orientation vers le bon interlocuteur, remplissage assisté de formulaires complexes. Un site bien structuré peut ainsi réduire fortement la friction avant le premier contact humain.
Les centres d’aide, les FAQ, les portails documentaires, les bibliothèques de ressources et les catalogues non marchands ont eux aussi un intérêt évident à être compatibles avec des usages agentiques. Lorsqu’un utilisateur demande une réponse précise, une synthèse ou une orientation, la valeur d’un contenu dépend de plus en plus de sa structure et de sa capacité à être extrait proprement.
Dans les espaces connectés, l’intérêt est encore plus concret. Suivre un dossier, consulter un historique, récupérer un document, créer une demande, ouvrir un ticket ou modifier des données de compte sont des actions qui peuvent être facilitées par des agents. Dans certains contextes B2B, cela peut représenter un vrai levier de productivité pour les clients comme pour les équipes internes.
Si le e-commerce concentre aujourd’hui l’attention, c’est parce qu’il réunit les meilleures conditions d’expérimentation. Les données y sont naturellement structurées, les intentions souvent explicites, les critères de comparaison mesurables, et le retour sur investissement très direct. C’est donc un laboratoire naturel. Mais il faut le voir comme un terrain d’avance, pas comme une frontière du sujet.
L’e-commerce agentique désigne un modèle dans lequel un ou plusieurs agents s’intercalent dans le parcours commercial, côté acheteur, côté marchand ou des deux côtés à la fois. L’agent ne se contente plus de suggérer. Il peut rechercher, comparer, présélectionner, ajouter au panier, réserver, et parfois aller jusqu’à la transaction complète. Cela modifie la nature de l’interaction commerciale.
Ce n’est ni un chatbot de service client, ni un moteur de recommandation plus avancé, ni une simple amélioration du tunnel d’achat. Dans l’e-commerce agentique, l’agent peut traiter une demande nouvelle, comparer des options réelles, arbitrer entre plusieurs contraintes et agir sur cette base.
Tous les sites marchands ne passeront pas d’un coup à l’achat totalement délégué. On observe plutôt une progression : d’abord l’information, puis l’assistance, ensuite la recommandation arbitrée, puis l’action structurée, et enfin, dans certains cas, la transaction complète. Cette progressivité est saine. Elle évite de courir après une vision maximaliste là où un niveau intermédiaire de maturité peut déjà créer beaucoup de valeur.
Dans une interaction agentique, l’utilisateur n’avance plus manuellement dans une succession d’écrans. Il exprime un objectif, puis une chaîne de traitement se met en place : compréhension de la demande, contextualisation, accès aux sources, comparaison, arbitrage, validation éventuelle, exécution et suivi. Chaque étape peut mobiliser des outils différents. Ce fonctionnement est valable pour un achat, mais aussi pour une demande de devis, une recherche documentaire ou une interaction de support.
Le modèle de langage joue le rôle de cerveau dans ce dispositif. Il comprend, reformule, planifie, hiérarchise et arbitre. Mais il ne connaît pas le stock réel d’un site, il n’a pas par défaut accès au CRM ni au système de paiement. Il doit donc s’appuyer sur des outils, des APIs et des systèmes externes.
Le web agentique s’appuie ainsi sur des APIs, des endpoints, des bases de données, des catalogues, des moteurs de recherche internes, des systèmes métier, des services d’authentification, des outils de paiement et des protocoles d’interconnexion. Un site n’est donc plus un objet isolé. Il devient un maillon dans une architecture beaucoup plus large.
Pour évaluer concrètement où se situe un site, un cadre simple est utile. Un site peut être lisible, interrogeable, actionnable et transactionnel :
Sans standard, un agent doit lire des pages HTML, en déduire leur structure, simuler des clics et espérer que le design n’ait pas changé depuis la veille. Avec des protocoles, il peut interroger des ressources structurées, appeler des outils et exécuter des actions selon des règles stables. C’est ce qui rend l’agentique industrialisable.
Le Model Context Protocol (MCP) est l’une des initiatives les plus importantes du moment. Développé initialement par Anthropic, il permet à un système d’exposer des outils, des ressources et des données de manière standardisée à des agents compatibles. Pour un CMS ou une plateforme web, cela ouvre la possibilité d’être utilisé de façon beaucoup plus directe et beaucoup plus propre par des systèmes externes.
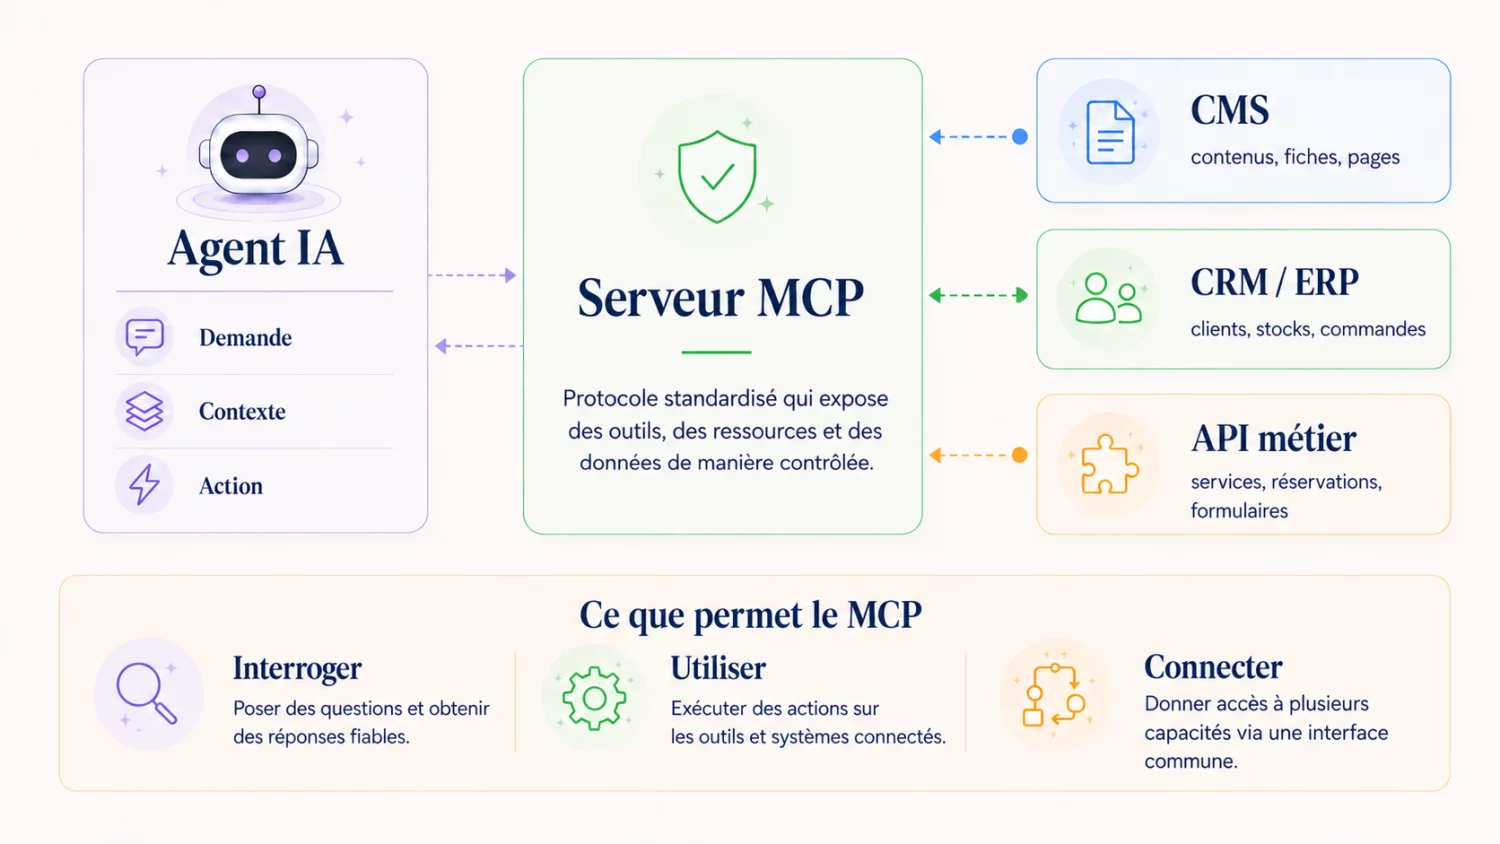
Le protocole Agent2Agent (A2A), lancé initialement par Google, complète cette logique. Le MCP organise principalement la relation entre un agent, ses outils et ses sources de données. A2A permet à des agents indépendants de se découvrir, de se confier des tâches et d’échanger des résultats. Depuis août 2026, MCP et A2A sont réunis au sein de l’Agentic AI Foundation, sous l’égide de la Linux Foundation. Ce rapprochement marque une étape importante vers un socle d’interopérabilité commun.
Dans le commerce, l’Universal Commerce Protocol (UCP) propose un langage commun entre les agents, les marchands et les prestataires de paiement. Sa documentation est désormais disponible et son intégration doit notamment permettre l’achat direct depuis le Mode IA de Google et Gemini. Avec l’Agent Payments Protocol, il montre comment les standards commencent à couvrir toute la chaîne, de la recherche d’un produit jusqu’au paiement.
L’enjeu n’est plus seulement d’être lu par une machine, mais d’être utilisé par elle. Cela signifie que les sites et plateformes capables d’exposer proprement leurs capacités, via APIs, serveurs MCP ou autres points d’entrée structurés, seront mécaniquement avantagés. Le scraping ne disparaîtra pas complètement, mais il deviendra de moins en moins la voie idéale.
Ces protocoles ne sont pas interchangeables. Ils couvrent des fonctions différentes et leur adoption reste encore progressive. La bonne approche, aujourd’hui, n’est donc ni l’attentisme complet, ni le surinvestissement prématuré dans un standard unique. Il faut surtout comprendre leur articulation et préparer une architecture capable de suivre ces évolutions sans douleur.
Le retard français n’était pas technique. Il était largement lié au cadre juridique des droits voisins et aux relations entre Google et les éditeurs de presse. L’amende de 250 millions d’euros infligée à Google par l’Autorité de la concurrence française en 2024 avait notamment rappelé la sensibilité du sujet. Le lancement français s’accompagne désormais de mécanismes de rémunération pour certains éditeurs et de nouveaux moyens de contrôler l’utilisation des contenus.
Depuis 2026, Google propose notamment aux propriétaires de sites un contrôle distinct dans Search Console pour refuser que leurs contenus alimentent les fonctionnalités génératives de Search sans disparaître pour autant des résultats classiques. Ce choix pose une question nouvelle : faut-il privilégier la possibilité d’être cité dans une réponse IA, au risque de recevoir moins de visites, ou protéger davantage ses contenus au risque de perdre ce nouveau point de visibilité ? Il n’existe pas de réponse universelle. Elle dépend du modèle économique, de la nature des contenus et de la valeur d’une visite sur le site.
Pour les entreprises françaises, il ne s’agit donc plus de se préparer à une évolution future. Il faut maintenant en mesurer les effets : suivre les pages et les requêtes les plus exposées, observer les variations de trafic et de conversion, identifier les contenus qui restent de véritables points d’entrée et renforcer ceux qui apportent une valeur que la réponse synthétique ne peut pas remplacer. La visibilité dans les réponses IA et la capacité à attirer ensuite l’utilisateur sur le site deviennent deux objectifs complémentaires.
Le référencement naturel ne disparaît pas, loin de là. Mais il ne peut plus être l’unique prisme. Les premières mesures disponibles montrent que l’apparition d’une réponse générée peut réduire sensiblement les clics. En Allemagne, Sistrix observe que le taux de clic du premier résultat passe de 27 à 11 % lorsque des AI Overviews sont affichés. Le recul est de l’ordre de 25 à 30 % pour les positions suivantes et atteint en moyenne 6,6 % de l’ensemble des clics organiques étudiés. Une étude publiée en 2026 estime de son côté à environ 15 % la baisse du trafic vers les articles de Wikipédia exposés à ces réponses. Ces résultats varient selon les sujets et les intentions de recherche, mais ils confirment qu’être bien classé ne suffit plus toujours si l’interface répond directement à la question.
Être visible ne veut donc plus seulement dire être bien classé. Cela veut aussi dire être compris, retenu et utilisé comme source dans la réponse elle-même.
C’est précisément l’enjeu du GEO (Generative Engine Optimization). Là où le SEO cherche d’abord à positionner une page dans une liste de liens, le GEO s’intéresse à la capacité d’un contenu à être compris, retenu et cité dans une réponse produite par un système IA.
Il ne faut toutefois pas présenter le GEO comme une discipline totalement séparée, avec ses propres recettes techniques. Google indique qu’aucune optimisation particulière n’est nécessaire pour apparaître dans AI Overviews ou le Mode IA et que les fondamentaux du SEO restent valables. Concrètement, la priorité reste la même : des contenus précis, des données structurées, des informations vérifiables et à jour, une architecture accessible et une autorité éditoriale bien établie. Le GEO ne remplace donc pas le SEO. Il en élargit le terrain et les critères de visibilité.
Dans ce contexte, le CMS joue un rôle direct. Il ne produit pas seulement des pages. Il organise la matière première du GEO : gabarits, champs, taxonomies, métadonnées, données structurées, cohérence éditoriale. Un bon GEO commence donc bien avant la rédaction finale.
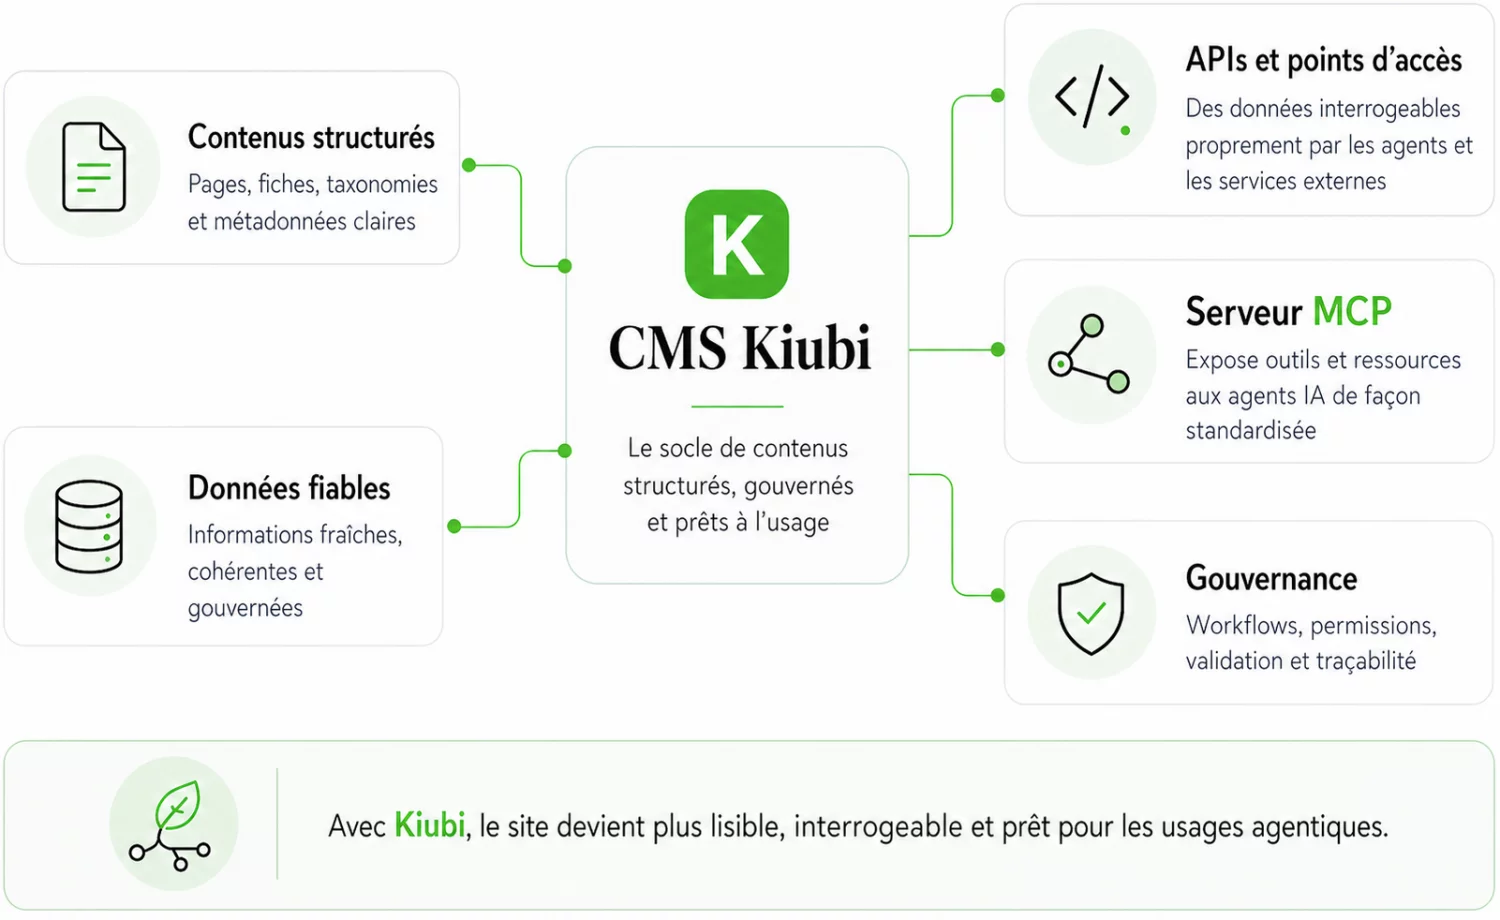
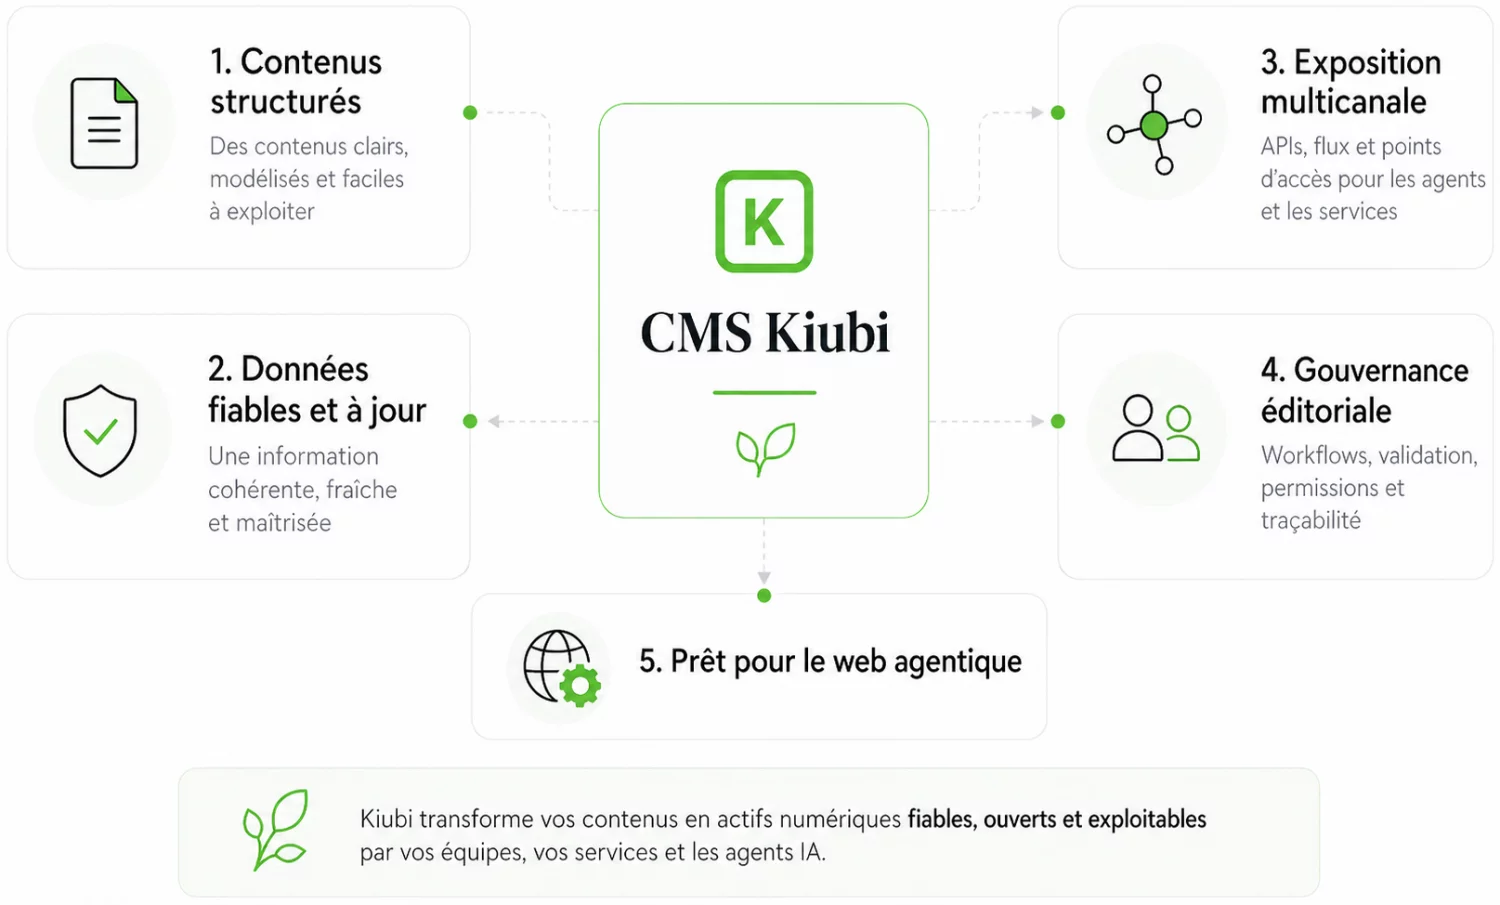
Dans un web agentique, le CMS est avant tout une infrastructure de données. Il modélise les contenus, impose une discipline éditoriale et produit mécaniquement un site lisible par une machine. Un bon HTML sémantique est nécessaire, mais ce qui compte vraiment c'est la cohérence du modèle de données sous-jacent : des contenus à jour, une organisation stable, des informations vérifiables. Un CMS qui garantit cette rigueur à la source rend le site exploitable par des agents sans travail supplémentaire.
Le rôle du CMS évolue aussi sur le plan de l'exposition. APIs, flux, endpoints, interconnexions avec les systèmes métier : un site bien conçu ne se limite plus à afficher des pages, il expose des ressources et, dans certains cas, des actions. C'est cette capacité qui conditionne la possibilité pour des agents d'interagir proprement avec lui.
Les agents n'aiment pas l'incohérence. Des contenus obsolètes, des stocks mal synchronisés ou une organisation éditoriale instable deviennent vite des handicaps. C'est là que les workflows, la validation et la gouvernance du contenu prennent une dimension nouvelle. On ne parle plus seulement d'organisation éditoriale. On parle de fiabilité opérationnelle.
L'agentique ne transforme pas seulement la façon dont les utilisateurs finaux interagissent avec un site. Il change aussi la façon dont les agences et les développeurs l'utilisent pour créer des sites. Un CMS capable d'exposer sa propre structure via un serveur MCP peut devenir le terrain de jeu d'agents dédiés au développement : aide à la création de templates, assistance à la configuration, génération de composants, compréhension du modèle de données. Le développement de sites entre lui aussi dans l'ère agentique, et les CMS qui anticipent cette dimension sont mieux positionnés pour l'accompagner.
Un CMS agent-ready n'est pas un CMS à la mode. C'est une plateforme capable d'allier cohérence des données, fraîcheur, exposition technique et contrôle des accès, avec moins de promesses spectaculaires et plus de rigueur dans les fondations.
Les bénéfices sont clairs. Moins de friction, plus de fluidité, de nouveaux points d’entrée vers les contenus et les services. Mais ces gains s’accompagnent aussi de limites concrètes. Les retailers qui s’intègrent à des plateformes comme l’UCP de Google ou ChatGPT délèguent une part significative de la relation client à un tiers algorithmique. Les erreurs d’interprétation, la dépendance à des données parfois imparfaites et le manque de transparence sur certains arbitrages sont des risques réels. À terme, les acteurs disposant des moyens d’investir dans ces plateformes pourraient capter l’essentiel de la visibilité agentique, au détriment des structures plus petites.
Dans ce contexte, la confiance devient une variable centrale. Les agents tendent à privilégier les sources jugées fiables, cohérentes, à jour et crédibles. La réputation, la qualité des contenus et la rigueur de la donnée deviennent donc des signaux de sélection à part entière.
La question de la souveraineté doit également être posée clairement. La plupart des entreprises ne contrôleront ni les grands modèles ni les grandes interfaces. En revanche, elles peuvent encore maîtriser leur infrastructure, leurs contenus, leurs données, leurs APIs et leurs règles d’exposition. C’est là que le CMS, la plateforme et l’architecture web retrouvent une importance stratégique. On ne contrôle pas l’agent ni ses critères exacts de sélection, mais on peut encore contrôler ce que l’on rend accessible, ce que l’on expose proprement et dans quelles conditions cela peut être utilisé.
En Europe, le développement des agents s’inscrit dans un cadre plus contraint que la seule possibilité technique. Le RGPD encadre l’utilisation des données personnelles, tandis que l’AI Act impose, selon la nature et le niveau de risque des usages, des obligations de transparence, de contrôle humain et de maîtrise des risques. Pour les entreprises, la question n’est donc pas seulement de savoir ce qu’un agent peut faire, mais aussi à quelles données il accède, où elles sont traitées, quelles actions il peut engager et qui en conserve la responsabilité. Certaines fonctions peuvent ainsi être limitées, retardées ou nécessiter des garanties supplémentaires avant leur déploiement.
La bonne réponse n’est donc pas de chercher un contrôle absolu, mais de préparer un cadre solide. Cela passe par des chantiers très concrets : mettre à jour les contenus, fiabiliser les métadonnées, structurer les données, définir les permissions, journaliser les actions et clarifier les points d’accès. Le sujet peut sembler abstrait vu de loin. En réalité, il ramène à quelque chose de très concret : la qualité du socle web et la capacité à garder la main sur ce que l’on expose.
Dans cette évolution, le CMS retrouve une place centrale. Il constitue le socle qui permet de publier des informations fiables, de les exposer à différents agents et d’en conserver la maîtrise. Le web agentique est donc à la fois technique, éditorial, économique et politique. C’est précisément ce qui le rend stratégique.
LLM (Large Language Model) : Grand modèle de langage, comme GPT-X ou Gemini. Système entraîné sur de grandes quantités de texte, capable de comprendre et de produire du langage naturel. C'est le moteur de raisonnement sur lequel s'appuient les agents IA.
Zero-clic : Phénomène par lequel une recherche se termine sans qu'aucun site web ne soit visité, parce que la réponse est affichée directement dans l'interface du moteur ou de l'assistant IA.
B2A2C (Business to Agent to Consumer) : Modèle dans lequel un agent IA s'intercale entre une entreprise et son client final. L'entreprise ne s'adresse plus directement au consommateur, mais à l'agent qui le représente et filtre l'information à sa place.
API (Application Programming Interface) : Interface technique qui permet à deux systèmes informatiques de communiquer et d'échanger des données de façon structurée et standardisée.
MCP (Model Context Protocol) : Standard ouvert qui permet à un système d'exposer ses outils, ressources et données à des agents IA de façon standardisée. Il facilite l'interconnexion entre un CMS, une plateforme web et des agents externes.
A2A (Agent2Agent) : Standard ouvert qui permet à des agents indépendants de se découvrir, de communiquer, de se confier des tâches et de partager leurs résultats. Il complète le MCP, davantage centré sur l'accès aux outils et aux données.
UCP (Universal Commerce Protocol) : Standard ouvert conçu pour permettre aux agents, aux marchands et aux prestataires de paiement d'échanger de façon structurée tout au long d'un parcours commercial, de la découverte d'un produit jusqu'à l'achat.
GEO (Generative Engine Optimization) : Ensemble de pratiques visant à rendre un contenu compréhensible, exploitable et susceptible d'être cité dans les réponses générées par des systèmes IA. Il prolonge les fondamentaux du SEO plutôt qu'il ne les remplace.
SEO (Search Engine Optimization) : Ensemble des pratiques visant à améliorer le positionnement d'un site web dans les résultats des moteurs de recherche classiques.
AI Overviews : Fonctionnalité de Google qui affiche une réponse synthétique générée par IA dans les résultats de recherche, accompagnée de liens permettant d'approfondir le sujet. Elle est disponible en France depuis le 22 juillet 2026.
Mode IA : Interface conversationnelle intégrée à Google Search qui permet de poser des questions complexes, d'ajouter des précisions et de poursuivre une recherche sans revenir à une succession classique de requêtes.
HTML sémantique : Usage du langage HTML en respectant la signification des balises (titres, paragraphes, listes, etc.) plutôt que leur seul rendu visuel. Un HTML sémantiquement propre est plus facilement compréhensible par les moteurs de recherche et les agents IA.
Scraping : Technique d'extraction automatique de données depuis des pages web, en simulant une navigation humaine. Méthode dégradée par rapport aux protocoles structurés, mais encore largement utilisée faute de mieux.
Cet article a été rédigé avec l'aide de l'IA et illustré avec l'IA. Sur un article parlant d'IA, cela eût été dommage de faire autrement.
Le web passe de la navigation à l’action
Pendant longtemps, le web a suivi une mécanique simple. Un utilisateur cherchait une information, ouvrait plusieurs pages, comparait, remplissait un formulaire ou ajoutait un produit au panier, puis décidait. Toute l’architecture des sites a été pensée pour ce parcours. Les interfaces, les menus, les pages catégories, les moteurs de recherche internes, et même les CMS reposent sur cette logique.Ce modèle ne disparaît pas, mais il évolue. Une nouvelle couche s’ajoute au web : celle de systèmes capables de comprendre une intention formulée en langage naturel, de rechercher des informations, de comparer des options et parfois d’agir à la place de l’utilisateur. Le web n’est plus seulement un espace que l’on parcourt. Il devient progressivement un environnement que l’on peut interroger pour obtenir un résultat.
Ce basculement n’est plus seulement annoncé. On cherche de plus en plus via des interfaces comme ChatGPT, Gemini ou Perplexity. Adobe relève dans son rapport 2026 qu’environ un quart des consommateurs citent les plateformes IA comme leur première source de recherche, devant les sites de marques et les avis en ligne, même si les moteurs classiques restent dominants. En parallèle, la tendance du zero clic s’accélère : moteurs et assistants donnent de plus en plus souvent une réponse directement dans leur interface, sans toujours renvoyer vers un site. En 2026, le lancement d’AI Overviews et du Mode IA en France, l’apparition de parcours d’achat intégrés et la structuration progressive des protocoles agentiques montrent que l’étape suivante est déjà engagée : les assistants ne se contentent plus d’informer. Ils commencent à comparer, recommander, remplir une demande ou lancer une action.
Comprendre le web agentique, ce n’est donc pas suivre une mode de plus autour de l’IA. C’est essayer de voir comment les sites web vont être lus, utilisés et parfois contournés par de nouveaux intermédiaires logiciels. C’est aussi comprendre pourquoi, dans ce nouveau paysage, le CMS redevient une brique stratégique, non seulement pour publier, mais pour structurer, exposer, gouverner et protéger l’information.
IA générative et IA agentique, deux logiques fondamentalement différentes
Avant de parler du web agentique, il faut clarifier le moteur qui le rend possible. Le mot agent est beaucoup employé, parfois un peu à tort. Entre un chatbot, une automatisation, un assistant et un agent, les frontières ne sont pas toujours très nettes. Or, si l’on veut comprendre les implications pour les sites et les CMS, il faut d’abord bien nommer les choses.Ce qu’est réellement un agent IA
Un agent IA est un système capable de poursuivre un objectif en enchaînant plusieurs actions de manière autonome ou semi-autonome. Ce qui le distingue d’un modèle de langage utilisé seul, comme celui qui alimente des interfaces de type ChatGPT, c’est qu’il ne se contente pas de produire une réponse. Il poursuit un objectif, planifie des étapes, utilise des outils et peut agir sur des systèmes externes.Un modèle de langage, le fameux LLM, produit du texte. Un chatbot répond à un échange. Une automatisation suit un scénario défini à l’avance. Un agent, lui, opère. Si on lui demande de trouver un outil adapté à une PME, de comparer des offres logistiques ou de réserver un créneau selon certaines contraintes, il peut aller chercher les informations, les organiser, arbitrer entre plusieurs options et agir sur cette base. C’est cette capacité à passer de la réponse à l’exécution qui change tout.
Ce que cela veut dire concrètement
Dit autrement, un agent n’est pas seulement un système à qui l’on pose une question. C’est un système à qui l’on peut confier un résultat à atteindre. Là où un outil conversationnel classique va expliquer comment faire quelque chose, un agent va essayer de le faire lui-même, ou au moins d’en préparer l’exécution.Sur un site de services, cela peut vouloir dire consulter des disponibilités, rapprocher plusieurs contraintes et préparer une prise de rendez-vous. Sur un site B2B, cela peut vouloir dire qualifier un besoin, retrouver la bonne ressource, structurer une demande ou préremplir un formulaire. Sur un site e-commerce, cela peut vouloir dire rechercher plusieurs produits, comparer leurs caractéristiques, vérifier leur disponibilité et proposer une sélection cohérente, voire aller jusqu’à l’ajout au panier ou à la préparation d’une transaction.
On le voit déjà dans des cas concrets. En janvier 2026, Carrefour a annoncé son adoption de l’Universal Commerce Protocol (UCP), le standard ouvert pour le commerce agentique lancé par Google au salon NRF, avec l’objectif de proposer des parcours d’achat intégrés directement dans Google Search et l’application Gemini dès que ces fonctionnalités seront déployées localement.
Puis en mars 2026, Carrefour a franchi une étape supplémentaire en lançant une intégration complète dans ChatGPT, devenant ainsi le premier retailer alimentaire européen à permettre de faire ses courses directement depuis l’interface d’OpenAI. Dans ces deux cas, on voit bien le glissement en cours : on passe d’interfaces qui informent à des systèmes qui commencent à guider, orchestrer et préparer une action réelle.
Les capacités qui rendent l’agentivité possible
Pour qu’un système soit réellement agentique, plusieurs briques doivent fonctionner ensemble. Il doit comprendre le langage naturel avec ses nuances, extraire les critères utiles, tenir compte du contexte, planifier plusieurs étapes, utiliser des outils externes et ajuster sa stratégie si les premiers résultats ne sont pas bons. Pris séparément, ces éléments ne sont pas nouveaux. C’est leur combinaison qui crée la rupture.Ce point est important pour les professionnels du web. Un site pensé pour une IA générative doit être lisible. Un site pensé pour des agents doit être à la fois lisible, interrogeable et, parfois, actionnable.
Le vrai niveau d’autonomie aujourd’hui
Il faut toutefois rester lucide. Le web agentique progresse vite, mais il n’est pas encore uniformément mature. Beaucoup de démonstrations sont impressionnantes, et certains cas d’usage sont déjà opérationnels, mais l’autonomie de l’agent doit rester encadrée dans la plupart des contextes.Fin septembre 2026, OpenAI a présenté Dots, des agents conçus pour poursuivre un travail entre plusieurs conversations et revenir vers l’utilisateur avec des résultats à valider. Cette logique d’agent persistant marque une étape supplémentaire : l’utilisateur ne déclenche plus seulement une action ponctuelle, il délègue un objectif dans la durée. Elle rend d’autant plus importante la définition préalable de ses limites d’action.
Cet encadrement ne repose pas uniquement sur une validation humaine. Il suppose aussi des permissions limitées, des confirmations avant les actions sensibles, une journalisation des opérations, des accès révocables et une responsabilité clairement définie en cas d’erreur. En pratique, beaucoup d’usages réels se situent encore entre recommandation, orchestration et exécution partielle. Pour les entreprises, le bon réflexe n’est donc pas de tout reconstruire dans l’urgence, mais de préparer progressivement le terrain.
Des systèmes experts aux LLMs, comment l’agentique est devenu possible
Le web agentique peut donner l’impression d’apparaître soudainement, alors qu’il s’inscrit dans une évolution plus longue. Les systèmes experts cherchaient déjà à reproduire un raisonnement spécialisé à partir de règles fixes. Les assistants grand public, comme Siri ou Alexa, ont ensuite introduit une première forme de délégation en langage naturel, mais dans des cas d’usage encore simples et très encadrés.Le véritable changement est venu avec les grands modèles de langage, capables de mieux comprendre les demandes humaines, leur contexte et leur complexité. Tant qu’ils restaient cantonnés à la production de réponses, on demeurait dans une logique conversationnelle. Le basculement vers l’agentique s’est produit lorsqu’ils ont commencé à utiliser des outils externes, comme des APIs, des services web ou des systèmes métiers, pour agir au-delà du simple texte.
Si l’accélération est si forte depuis peu, c’est parce que plusieurs conditions sont désormais réunies : des modèles plus robustes, des usages conversationnels déjà installés, des investissements massifs des grandes plateformes et l’émergence progressive de standards d’interconnexion. Le web agentique n’est donc pas un surgissement isolé. C’est le point de rencontre entre une maturation technique, une évolution des usages et un besoin croissant de simplifier des parcours numériques devenus trop complexes. Cette dynamique ne se limite pas aux grandes plateformes, elle touche aussi l’open source avec des projets comme Hermes Agent de Nous Research.
Le modèle B2A2C, quand les agents s’intercalent entre le site et l’utilisateur
Si l’IA agentique change la nature des systèmes, le web agentique change la nature des sites. C’est probablement le point le plus important pour des agences, des PME, des PMI ou des institutions. Pendant longtemps, un site a été conçu comme une interface à parcourir. Désormais, il doit aussi pouvoir être compris, interrogé et parfois utilisé par des agents qui ne le verront jamais comme un humain le voit.Le web agentique, en clair
Le web agentique désigne un environnement dans lequel des agents IA s’intercalent entre l’utilisateur et les services en ligne. Au lieu de visiter directement un site, l’utilisateur exprime une intention et laisse un système chercher, comparer, synthétiser ou agir. On ne remplace pas totalement la navigation humaine, mais on lui ajoute un mode d’accès nouveau, plus direct et plus opérant.Pour situer ce changement, on peut résumer l’évolution du web assez simplement :
Cette progression illustre comment chaque phase a prolongé et reconfiguré les précédentes sans les effacer. Le web agentique ne fait pas exception : la navigation humaine reste présente, mais elle coexiste avec de nouveaux modes d’accès où l’intention est déléguée à un système intermédiaire.
B2A2C, être d’abord sélectionné par une machine avant d’atteindre un humain
Un site n’est plus seulement une façade. Il devient aussi une source de données, une base de réponses et un point d’accès à des actions. Sa qualité ne se mesure plus uniquement à son ergonomie, à sa charte graphique ou à ses performances techniques. Elle se mesure aussi à sa capacité à rendre l’information exploitable par une machine.C’est précisément là que la logique s’inverse : pour exister dans le web agentique, un site doit d’abord être compris et sélectionné par une machine avant d’atteindre l’utilisateur humain. Un site dont les contenus sont flous, les données peu structurées ou les services uniquement accessibles par une navigation humaine risque donc d’être ignoré, quelle que soit la qualité de sa présentation.
C’est ce que résume le modèle B2A2C (Business to Agent to Consumer) : l’entreprise ne s’adresse plus directement au consommateur, mais à l’agent qui le représente. Cela change la visibilité, la découverte et parfois la relation client elle-même.
Le web agentique va bien au-delà du commerce en ligne
Le commerce en ligne est le cas le plus visible, mais ce serait une erreur de croire que le web agentique se limite aux sites marchands. Pour une grande partie des entreprises, ce n’est même pas le point d’entrée principal. Les sites de services, institutionnels, documentaires ou métiers sont eux aussi concernés, parfois de façon très directe.Sur un site de services, les usages sont assez faciles à imaginer : prise de rendez-vous, qualification d’une demande, demande de devis, orientation vers le bon interlocuteur, remplissage assisté de formulaires complexes. Un site bien structuré peut ainsi réduire fortement la friction avant le premier contact humain.
Les centres d’aide, les FAQ, les portails documentaires, les bibliothèques de ressources et les catalogues non marchands ont eux aussi un intérêt évident à être compatibles avec des usages agentiques. Lorsqu’un utilisateur demande une réponse précise, une synthèse ou une orientation, la valeur d’un contenu dépend de plus en plus de sa structure et de sa capacité à être extrait proprement.
Dans les espaces connectés, l’intérêt est encore plus concret. Suivre un dossier, consulter un historique, récupérer un document, créer une demande, ouvrir un ticket ou modifier des données de compte sont des actions qui peuvent être facilitées par des agents. Dans certains contextes B2B, cela peut représenter un vrai levier de productivité pour les clients comme pour les équipes internes.
Si le e-commerce concentre aujourd’hui l’attention, c’est parce qu’il réunit les meilleures conditions d’expérimentation. Les données y sont naturellement structurées, les intentions souvent explicites, les critères de comparaison mesurables, et le retour sur investissement très direct. C’est donc un laboratoire naturel. Mais il faut le voir comme un terrain d’avance, pas comme une frontière du sujet.
L’e-commerce agentique n’est pas un simple gadget de plus
Si le commerce en ligne concentre autant d’attention, c’est aussi parce qu’il est le domaine où l’agentique devient immédiatement tangible. Les démonstrations sont parlantes, les bénéfices potentiels faciles à comprendre, et les arbitrages assez mesurables. Mais pour éviter les contresens, il faut poser clairement ce qu’est l’e-commerce agentique, et ce qu’il n’est pas.L’e-commerce agentique désigne un modèle dans lequel un ou plusieurs agents s’intercalent dans le parcours commercial, côté acheteur, côté marchand ou des deux côtés à la fois. L’agent ne se contente plus de suggérer. Il peut rechercher, comparer, présélectionner, ajouter au panier, réserver, et parfois aller jusqu’à la transaction complète. Cela modifie la nature de l’interaction commerciale.
Ce n’est ni un chatbot de service client, ni un moteur de recommandation plus avancé, ni une simple amélioration du tunnel d’achat. Dans l’e-commerce agentique, l’agent peut traiter une demande nouvelle, comparer des options réelles, arbitrer entre plusieurs contraintes et agir sur cette base.
Tous les sites marchands ne passeront pas d’un coup à l’achat totalement délégué. On observe plutôt une progression : d’abord l’information, puis l’assistance, ensuite la recommandation arbitrée, puis l’action structurée, et enfin, dans certains cas, la transaction complète. Cette progressivité est saine. Elle évite de courir après une vision maximaliste là où un niveau intermédiaire de maturité peut déjà créer beaucoup de valeur.
APIs, LLMs et systèmes métier, comment fonctionne une interaction agentique
Pour les agences et les directions digitales, le sujet devient vraiment concret quand on regarde la mécanique réelle. Le web agentique n’est pas une magie qui se superpose aux sites. C’est une chaîne technique, éditoriale et applicative où chaque maillon compte.Dans une interaction agentique, l’utilisateur n’avance plus manuellement dans une succession d’écrans. Il exprime un objectif, puis une chaîne de traitement se met en place : compréhension de la demande, contextualisation, accès aux sources, comparaison, arbitrage, validation éventuelle, exécution et suivi. Chaque étape peut mobiliser des outils différents. Ce fonctionnement est valable pour un achat, mais aussi pour une demande de devis, une recherche documentaire ou une interaction de support.
Le modèle de langage joue le rôle de cerveau dans ce dispositif. Il comprend, reformule, planifie, hiérarchise et arbitre. Mais il ne connaît pas le stock réel d’un site, il n’a pas par défaut accès au CRM ni au système de paiement. Il doit donc s’appuyer sur des outils, des APIs et des systèmes externes.
Le web agentique s’appuie ainsi sur des APIs, des endpoints, des bases de données, des catalogues, des moteurs de recherche internes, des systèmes métier, des services d’authentification, des outils de paiement et des protocoles d’interconnexion. Un site n’est donc plus un objet isolé. Il devient un maillon dans une architecture beaucoup plus large.
Pour évaluer concrètement où se situe un site, un cadre simple est utile. Un site peut être lisible, interrogeable, actionnable et transactionnel :
- Lisible signifie que son contenu est structuré et compréhensible par une machine
- Interrogeable signifie que ses données peuvent être récupérées proprement
- Actionnable signifie que certaines opérations peuvent être déclenchées sans simulation de navigation humaine
- Transactionnel signifie qu’une opération complète peut être réalisée avec sécurité et traçabilité
MCP, A2A et UCP, l’écosystème agentique commence à se structurer
Sans standards, le web agentique resterait une collection de bricolages plus ou moins fragiles. Pour que des agents puissent interagir avec des sites, des CMS, des catalogues ou des services de façon propre, il faut une couche d’interopérabilité. Elle est encore en construction, mais elle devient déjà un enjeu concret.Sans standard, un agent doit lire des pages HTML, en déduire leur structure, simuler des clics et espérer que le design n’ait pas changé depuis la veille. Avec des protocoles, il peut interroger des ressources structurées, appeler des outils et exécuter des actions selon des règles stables. C’est ce qui rend l’agentique industrialisable.
Le Model Context Protocol (MCP) est l’une des initiatives les plus importantes du moment. Développé initialement par Anthropic, il permet à un système d’exposer des outils, des ressources et des données de manière standardisée à des agents compatibles. Pour un CMS ou une plateforme web, cela ouvre la possibilité d’être utilisé de façon beaucoup plus directe et beaucoup plus propre par des systèmes externes.
Le protocole Agent2Agent (A2A), lancé initialement par Google, complète cette logique. Le MCP organise principalement la relation entre un agent, ses outils et ses sources de données. A2A permet à des agents indépendants de se découvrir, de se confier des tâches et d’échanger des résultats. Depuis août 2026, MCP et A2A sont réunis au sein de l’Agentic AI Foundation, sous l’égide de la Linux Foundation. Ce rapprochement marque une étape importante vers un socle d’interopérabilité commun.
Dans le commerce, l’Universal Commerce Protocol (UCP) propose un langage commun entre les agents, les marchands et les prestataires de paiement. Sa documentation est désormais disponible et son intégration doit notamment permettre l’achat direct depuis le Mode IA de Google et Gemini. Avec l’Agent Payments Protocol, il montre comment les standards commencent à couvrir toute la chaîne, de la recherche d’un produit jusqu’au paiement.
L’enjeu n’est plus seulement d’être lu par une machine, mais d’être utilisé par elle. Cela signifie que les sites et plateformes capables d’exposer proprement leurs capacités, via APIs, serveurs MCP ou autres points d’entrée structurés, seront mécaniquement avantagés. Le scraping ne disparaîtra pas complètement, mais il deviendra de moins en moins la voie idéale.
Ces protocoles ne sont pas interchangeables. Ils couvrent des fonctions différentes et leur adoption reste encore progressive. La bonne approche, aujourd’hui, n’est donc ni l’attentisme complet, ni le surinvestissement prématuré dans un standard unique. Il faut surtout comprendre leur articulation et préparer une architecture capable de suivre ces évolutions sans douleur.
AI Overviews en France, le changement est désormais concret
Depuis le 22 juillet 2026, AI Overviews et le Mode IA sont disponibles en France. Les utilisateurs peuvent obtenir une synthèse directement dans les résultats, puis poursuivre leur recherche dans une interface conversationnelle. Le changement qui était encore anticipé quelques mois auparavant est donc devenu concret.Le retard français n’était pas technique. Il était largement lié au cadre juridique des droits voisins et aux relations entre Google et les éditeurs de presse. L’amende de 250 millions d’euros infligée à Google par l’Autorité de la concurrence française en 2024 avait notamment rappelé la sensibilité du sujet. Le lancement français s’accompagne désormais de mécanismes de rémunération pour certains éditeurs et de nouveaux moyens de contrôler l’utilisation des contenus.
Depuis 2026, Google propose notamment aux propriétaires de sites un contrôle distinct dans Search Console pour refuser que leurs contenus alimentent les fonctionnalités génératives de Search sans disparaître pour autant des résultats classiques. Ce choix pose une question nouvelle : faut-il privilégier la possibilité d’être cité dans une réponse IA, au risque de recevoir moins de visites, ou protéger davantage ses contenus au risque de perdre ce nouveau point de visibilité ? Il n’existe pas de réponse universelle. Elle dépend du modèle économique, de la nature des contenus et de la valeur d’une visite sur le site.
Pour les entreprises françaises, il ne s’agit donc plus de se préparer à une évolution future. Il faut maintenant en mesurer les effets : suivre les pages et les requêtes les plus exposées, observer les variations de trafic et de conversion, identifier les contenus qui restent de véritables points d’entrée et renforcer ceux qui apportent une valeur que la réponse synthétique ne peut pas remplacer. La visibilité dans les réponses IA et la capacité à attirer ensuite l’utilisateur sur le site deviennent deux objectifs complémentaires.
Zero-clic et GEO, la fin du classement comme seul enjeu
L’agentique ne transforme pas seulement les usages et les architectures. Elle change aussi la manière dont un site devient visible. Pendant longtemps, l’essentiel de la bataille se jouait dans les résultats de recherche classiques. Désormais, une part croissante de la visibilité se construit dans les réponses générées, les citations et les recommandations formulées par des systèmes IA.Le référencement naturel ne disparaît pas, loin de là. Mais il ne peut plus être l’unique prisme. Les premières mesures disponibles montrent que l’apparition d’une réponse générée peut réduire sensiblement les clics. En Allemagne, Sistrix observe que le taux de clic du premier résultat passe de 27 à 11 % lorsque des AI Overviews sont affichés. Le recul est de l’ordre de 25 à 30 % pour les positions suivantes et atteint en moyenne 6,6 % de l’ensemble des clics organiques étudiés. Une étude publiée en 2026 estime de son côté à environ 15 % la baisse du trafic vers les articles de Wikipédia exposés à ces réponses. Ces résultats varient selon les sujets et les intentions de recherche, mais ils confirment qu’être bien classé ne suffit plus toujours si l’interface répond directement à la question.
Être visible ne veut donc plus seulement dire être bien classé. Cela veut aussi dire être compris, retenu et utilisé comme source dans la réponse elle-même.
C’est précisément l’enjeu du GEO (Generative Engine Optimization). Là où le SEO cherche d’abord à positionner une page dans une liste de liens, le GEO s’intéresse à la capacité d’un contenu à être compris, retenu et cité dans une réponse produite par un système IA.
Il ne faut toutefois pas présenter le GEO comme une discipline totalement séparée, avec ses propres recettes techniques. Google indique qu’aucune optimisation particulière n’est nécessaire pour apparaître dans AI Overviews ou le Mode IA et que les fondamentaux du SEO restent valables. Concrètement, la priorité reste la même : des contenus précis, des données structurées, des informations vérifiables et à jour, une architecture accessible et une autorité éditoriale bien établie. Le GEO ne remplace donc pas le SEO. Il en élargit le terrain et les critères de visibilité.
Dans ce contexte, le CMS joue un rôle direct. Il ne produit pas seulement des pages. Il organise la matière première du GEO : gabarits, champs, taxonomies, métadonnées, données structurées, cohérence éditoriale. Un bon GEO commence donc bien avant la rédaction finale.
Le CMS comme infrastructure de données pour structurer, exposer, gouverner
Il pourrait sembler paradoxal que des agents capables de court-circuiter la navigation humaine renforcent en réalité le rôle du CMS. Mais les agents ne fonctionnent pas dans le vide : ils s'appuient sur des sources. Ce n'est donc pas le CMS qui perd de l'importance, mais la qualité du socle de données qu'il produit qui devient déterminante.Dans un web agentique, le CMS est avant tout une infrastructure de données. Il modélise les contenus, impose une discipline éditoriale et produit mécaniquement un site lisible par une machine. Un bon HTML sémantique est nécessaire, mais ce qui compte vraiment c'est la cohérence du modèle de données sous-jacent : des contenus à jour, une organisation stable, des informations vérifiables. Un CMS qui garantit cette rigueur à la source rend le site exploitable par des agents sans travail supplémentaire.
Le rôle du CMS évolue aussi sur le plan de l'exposition. APIs, flux, endpoints, interconnexions avec les systèmes métier : un site bien conçu ne se limite plus à afficher des pages, il expose des ressources et, dans certains cas, des actions. C'est cette capacité qui conditionne la possibilité pour des agents d'interagir proprement avec lui.
Les agents n'aiment pas l'incohérence. Des contenus obsolètes, des stocks mal synchronisés ou une organisation éditoriale instable deviennent vite des handicaps. C'est là que les workflows, la validation et la gouvernance du contenu prennent une dimension nouvelle. On ne parle plus seulement d'organisation éditoriale. On parle de fiabilité opérationnelle.
L'agentique ne transforme pas seulement la façon dont les utilisateurs finaux interagissent avec un site. Il change aussi la façon dont les agences et les développeurs l'utilisent pour créer des sites. Un CMS capable d'exposer sa propre structure via un serveur MCP peut devenir le terrain de jeu d'agents dédiés au développement : aide à la création de templates, assistance à la configuration, génération de composants, compréhension du modèle de données. Le développement de sites entre lui aussi dans l'ère agentique, et les CMS qui anticipent cette dimension sont mieux positionnés pour l'accompagner.
Un CMS agent-ready n'est pas un CMS à la mode. C'est une plateforme capable d'allier cohérence des données, fraîcheur, exposition technique et contrôle des accès, avec moins de promesses spectaculaires et plus de rigueur dans les fondations.
Souveraineté et dépendance, garder la main malgré les plateformes
Le web agentique ouvre des opportunités réelles, mais il introduit aussi de nouvelles dépendances. Les grands modèles, les interfaces conversationnelles et une partie croissante des règles de sélection sont contrôlés par quelques grands acteurs internationaux. Pour les entreprises, les institutions et les agences, cela change la donne : il ne suffit plus d’être présent sur le web, il faut aussi réfléchir à la manière dont ses contenus, ses données et ses services seront lus, interprétés et utilisés par des intermédiaires que l’on ne maîtrise pas complètement.Les bénéfices sont clairs. Moins de friction, plus de fluidité, de nouveaux points d’entrée vers les contenus et les services. Mais ces gains s’accompagnent aussi de limites concrètes. Les retailers qui s’intègrent à des plateformes comme l’UCP de Google ou ChatGPT délèguent une part significative de la relation client à un tiers algorithmique. Les erreurs d’interprétation, la dépendance à des données parfois imparfaites et le manque de transparence sur certains arbitrages sont des risques réels. À terme, les acteurs disposant des moyens d’investir dans ces plateformes pourraient capter l’essentiel de la visibilité agentique, au détriment des structures plus petites.
Dans ce contexte, la confiance devient une variable centrale. Les agents tendent à privilégier les sources jugées fiables, cohérentes, à jour et crédibles. La réputation, la qualité des contenus et la rigueur de la donnée deviennent donc des signaux de sélection à part entière.
La question de la souveraineté doit également être posée clairement. La plupart des entreprises ne contrôleront ni les grands modèles ni les grandes interfaces. En revanche, elles peuvent encore maîtriser leur infrastructure, leurs contenus, leurs données, leurs APIs et leurs règles d’exposition. C’est là que le CMS, la plateforme et l’architecture web retrouvent une importance stratégique. On ne contrôle pas l’agent ni ses critères exacts de sélection, mais on peut encore contrôler ce que l’on rend accessible, ce que l’on expose proprement et dans quelles conditions cela peut être utilisé.
En Europe, le développement des agents s’inscrit dans un cadre plus contraint que la seule possibilité technique. Le RGPD encadre l’utilisation des données personnelles, tandis que l’AI Act impose, selon la nature et le niveau de risque des usages, des obligations de transparence, de contrôle humain et de maîtrise des risques. Pour les entreprises, la question n’est donc pas seulement de savoir ce qu’un agent peut faire, mais aussi à quelles données il accède, où elles sont traitées, quelles actions il peut engager et qui en conserve la responsabilité. Certaines fonctions peuvent ainsi être limitées, retardées ou nécessiter des garanties supplémentaires avant leur déploiement.
La bonne réponse n’est donc pas de chercher un contrôle absolu, mais de préparer un cadre solide. Cela passe par des chantiers très concrets : mettre à jour les contenus, fiabiliser les métadonnées, structurer les données, définir les permissions, journaliser les actions et clarifier les points d’accès. Le sujet peut sembler abstrait vu de loin. En réalité, il ramène à quelque chose de très concret : la qualité du socle web et la capacité à garder la main sur ce que l’on expose.
Le web devient programmable par intention et par délégation
Le changement en cours est profond, mais il n’a rien de magique. Le web ne s’efface pas. Il se transforme. On passe progressivement d’un modèle centré sur la navigation humaine à un modèle où une partie croissante des usages passe par la délégation à des systèmes intermédiaires. L’utilisateur ne demande plus seulement une réponse : il peut confier à un agent la recherche, la comparaison et parfois l’exécution d’une action. Cette mutation concerne les marchands, bien sûr, mais aussi les institutions, les PME, les PMI, les agences et tous les acteurs qui publient des contenus ou exposent des services en ligne.Dans cette évolution, le CMS retrouve une place centrale. Il constitue le socle qui permet de publier des informations fiables, de les exposer à différents agents et d’en conserver la maîtrise. Le web agentique est donc à la fois technique, éditorial, économique et politique. C’est précisément ce qui le rend stratégique.
Glossaire
Agent IA : Système capable de poursuivre un objectif en enchaînant plusieurs actions de façon autonome. Contrairement à un simple chatbot, il ne se contente pas de répondre : il planifie, utilise des outils et agit sur des systèmes externes.LLM (Large Language Model) : Grand modèle de langage, comme GPT-X ou Gemini. Système entraîné sur de grandes quantités de texte, capable de comprendre et de produire du langage naturel. C'est le moteur de raisonnement sur lequel s'appuient les agents IA.
Zero-clic : Phénomène par lequel une recherche se termine sans qu'aucun site web ne soit visité, parce que la réponse est affichée directement dans l'interface du moteur ou de l'assistant IA.
B2A2C (Business to Agent to Consumer) : Modèle dans lequel un agent IA s'intercale entre une entreprise et son client final. L'entreprise ne s'adresse plus directement au consommateur, mais à l'agent qui le représente et filtre l'information à sa place.
API (Application Programming Interface) : Interface technique qui permet à deux systèmes informatiques de communiquer et d'échanger des données de façon structurée et standardisée.
MCP (Model Context Protocol) : Standard ouvert qui permet à un système d'exposer ses outils, ressources et données à des agents IA de façon standardisée. Il facilite l'interconnexion entre un CMS, une plateforme web et des agents externes.
A2A (Agent2Agent) : Standard ouvert qui permet à des agents indépendants de se découvrir, de communiquer, de se confier des tâches et de partager leurs résultats. Il complète le MCP, davantage centré sur l'accès aux outils et aux données.
UCP (Universal Commerce Protocol) : Standard ouvert conçu pour permettre aux agents, aux marchands et aux prestataires de paiement d'échanger de façon structurée tout au long d'un parcours commercial, de la découverte d'un produit jusqu'à l'achat.
GEO (Generative Engine Optimization) : Ensemble de pratiques visant à rendre un contenu compréhensible, exploitable et susceptible d'être cité dans les réponses générées par des systèmes IA. Il prolonge les fondamentaux du SEO plutôt qu'il ne les remplace.
SEO (Search Engine Optimization) : Ensemble des pratiques visant à améliorer le positionnement d'un site web dans les résultats des moteurs de recherche classiques.
AI Overviews : Fonctionnalité de Google qui affiche une réponse synthétique générée par IA dans les résultats de recherche, accompagnée de liens permettant d'approfondir le sujet. Elle est disponible en France depuis le 22 juillet 2026.
Mode IA : Interface conversationnelle intégrée à Google Search qui permet de poser des questions complexes, d'ajouter des précisions et de poursuivre une recherche sans revenir à une succession classique de requêtes.
HTML sémantique : Usage du langage HTML en respectant la signification des balises (titres, paragraphes, listes, etc.) plutôt que leur seul rendu visuel. Un HTML sémantiquement propre est plus facilement compréhensible par les moteurs de recherche et les agents IA.
Scraping : Technique d'extraction automatique de données depuis des pages web, en simulant une navigation humaine. Méthode dégradée par rapport aux protocoles structurés, mais encore largement utilisée faute de mieux.
Cet article a été rédigé avec l'aide de l'IA et illustré avec l'IA. Sur un article parlant d'IA, cela eût été dommage de faire autrement.